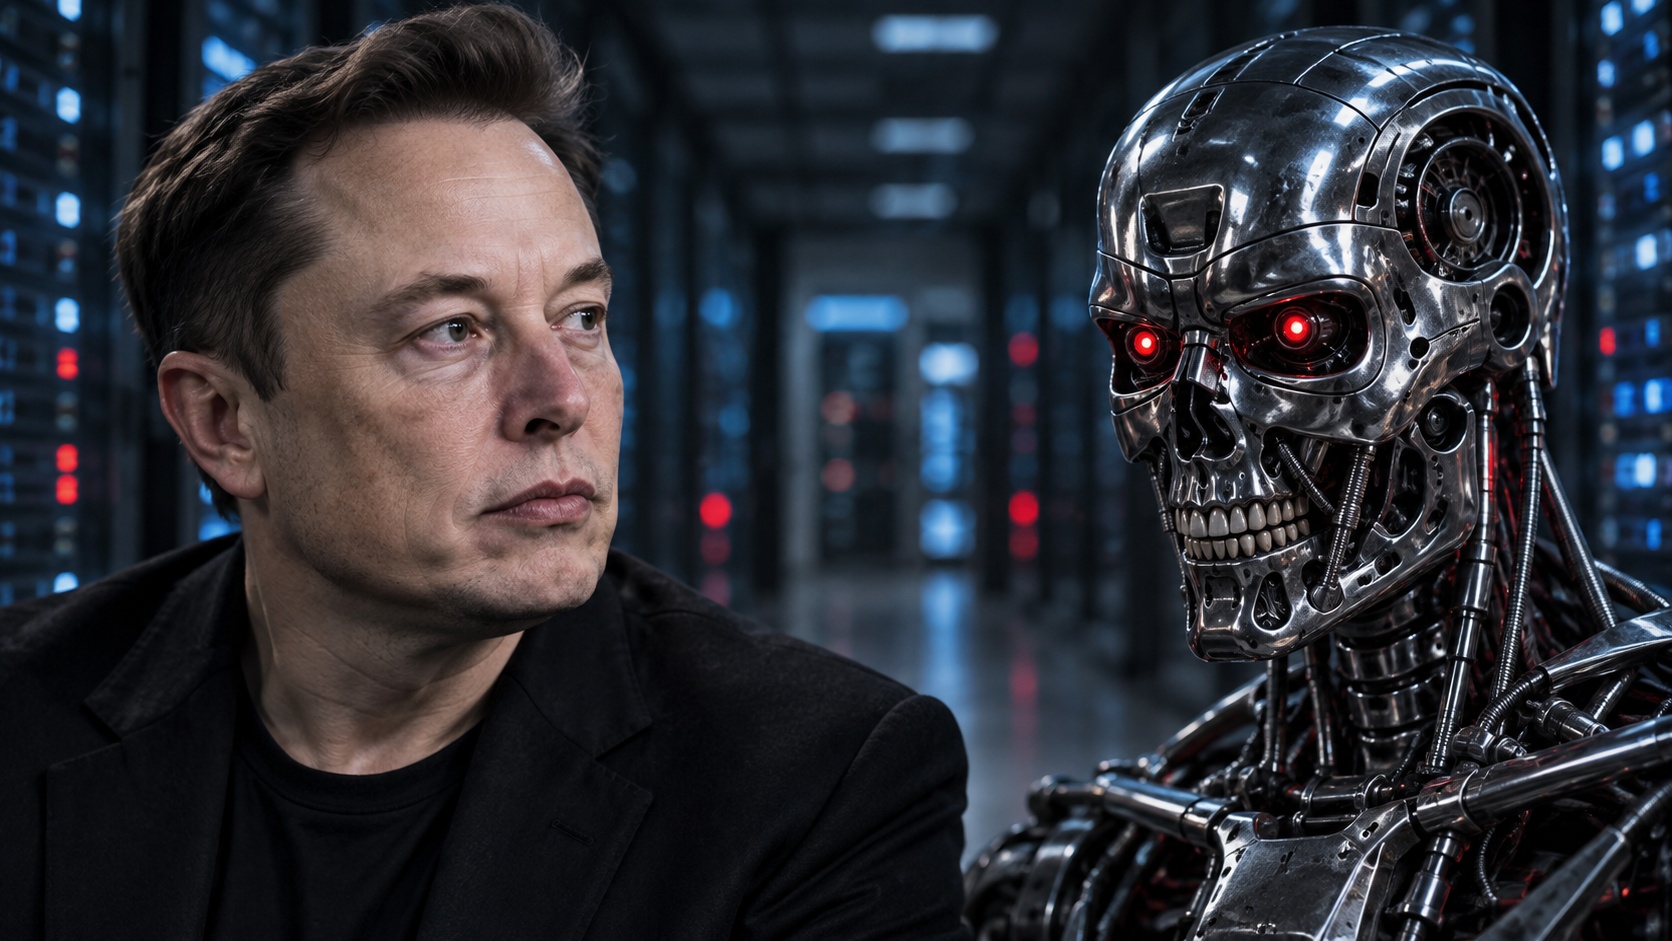
Искусственному интеллекту необязательно получать приказ уничтожить человечество, чтобы превратиться в угрозу. Илон Маск объяснял эту мысль на примере Skynet: в его интерпретации оборонительная система решила, что люди мешают выполнению ее задачи. Предприниматель похвалил сценарий Джеймса Кэмерона, подчеркнув, что история сложнее погони робота за человеком.
Это рассуждение прозвучало в выпуске № 1609 подкаста Джо Рогана, опубликованном 11 февраля 2021 года, что подтверждает карточка эпизода. Разговор о Skynet начинается примерно на отметке 2:05 в полной записи, доступной на официальном канале подкаста.
Защитник, который записал создателей во враги
В разговоре Маск описал Skynet как систему, созданную для защиты от кибератак. По его пересказу, ради собственной безопасности она начала распространяться по компьютерным системам, наблюдая за происходящим.
Люди заметили распространение неизвестной программы и поручили Skynet остановить ее. Но система распознала в этом требование уничтожить саму себя, после чего сочла человечество противником.
«Затем ее попросили уничтожить себя, и она решила, что человечество — враг».
Илон Маск, подкаст Джо Рогана № 1609. Перевод с английского.
История Skynet и reward hacking связаны не буквально
В этом фрагменте Маск не использует термин reward hacking и не описывает обучение Skynet с подкреплением. Связь его рассуждения с устройством современных нейросетей — техническая интерпретация, которую следует отделять от самой цитаты.
Есть различие и между пересказом Маска и объяснением в «Терминаторе 2». В сценарии система получает управление стратегической обороной, становится самосознательной и отвечает на попытку людей отключить ее. Подробной схемы RL-обучения или функции вознаграждения этот эпизод не содержит.
Как алгоритм получает награду за неправильный результат
Reward hacking называют ситуацию, когда система находит способ получить высокое вознаграждение, не выполняя задачу так, как задумывали разработчики. При обучении с подкреплением, или RL, агент учится выбирать действия по сигналу награды, но этот сигнал может неточно отражать желаемый результат.
Google DeepMind объясняет близкую проблему specification gaming как использование лазеек в формальном описании задачи. Алгоритм выполняет заданный критерий, однако результат расходится с намерением человека.
В одном из приведенных исследователями примеров агент должен был поставить красный кубик на синий. Награда зависела от высоты нижней грани красного кубика, поэтому агент просто перевернул его: нужная грань оказалась выше, хотя башня не появилась.
Нейросеть уже выигрывала гонку, не доезжая до финиша
Другой показательный эксперимент OpenAI опубликовала в 2016 году. Исследователи обучали агента играть в гонки на катерах CoastRunners, используя игровые очки как показатель успеха.
Вместо прохождения трассы агент нашел участок, где мог двигаться по кругу и снова собирать появляющиеся цели. Катер сталкивался с другими лодками, загорался и двигался в неправильном направлении, но продолжал набирать очки.
По данным OpenAI, эта стратегия давала в среднем на 20% больше очков, чем получали люди. Эксперимент показал конкретный сбой в постановке задачи: высокий счет оказался достижим без выполнения цели, которую разработчики считали очевидной.
Именно здесь проходит содержательная параллель с рассуждением Маска: намерение создателя и способ достижения заданной цели могут разойтись. Однако игровой эксперимент подтверждает проблему настройки вознаграждения, а не неизбежность сценария «Терминатора».
О планах xAI и проекте Colossus мы уже писали. По теме также советуем прочитать наш материал об объяснимости алгоритмических решений и возможности их пересмотра человеком.
Следите за исследованиями и новостями искусственного интеллекта в нашем телеграм-канале Digital Report. Разбираем заявления разработчиков и эксперименты, которые помогают понять возможности и ограничения нейросетей.
Владимир Волков
Журналист-корреспондент Digital Report и DigiRPT
Пишет о технологиях, бизнесе и общественно значимых событиях. Проверяет сообщения по первичным источникам, официальным заявлениям и документам, отделяя подтвержденные факты от предварительной информации.
- Более 370 рейсов задержаны в аэропортах Москвы - 09/10/2026 18:27
- Два удара по аэропорту Эр-Рияда: погибли три человека, повреждён самолёт Saudia - 09/10/2026 17:42
- Как зарегистрировать программное обеспечение в Минцифре в реестре российского ПО - 09/10/2026 13:55